

中信建投:国产模型迭代推动需求增长 关注企业级AI应用、算力服务等
智通财经APP获悉,中信建投发布研报称,DeepSeek更新Flash模型,在保持低价的同时提升编程和自动化任务表现,并开放搜索与内容抓取能力;此外,智谱发布法律专用模型,阶跃披露长程Agent训练方案。国产模型能力、调用成本和工具配套改善,有望扩大Agent在代码开发、数据分析及企业业务系统中的应用范围,推动企业工作流应用与推理需求增长,建议关注企业级AI应用、算力服务及国产芯片和超节点。
中信建投主要观点如下:
DeepSeek更新Flash模型,编程与Agent任务能力改善。10月17日,DeepSeek发布V4.1-Flash-1017,官方网页端、App和API同步切换,API调用方式与价格保持不变。本次更新以9月10日发布的V4.1 Flash为基础,改善推理、编程、自动化及视觉任务表现,并针对DeepSeek Harness、腾讯CodeBuddy、WorkBuddy等框架优化。V4.1 Flash侧重高效率和低成本调用,本次升级进一步扩大了其可承接的工程任务范围。公司通过基于自反馈的强化学习,增强模型从需求描述出发构建完整项目的能力,展示了3D建模、网页游戏及基于Godot的游戏开发案例,应用能力由代码生成延伸至工具调用、结果检查和多轮修正。
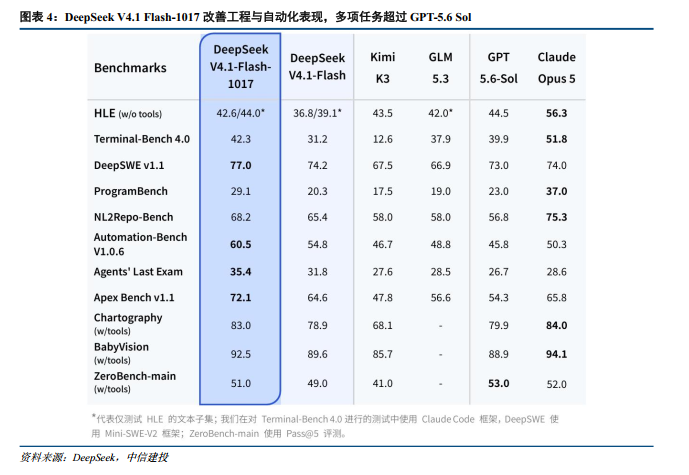
工程与自动化评测明显提升,部分任务成绩超过GPT-5.6 Sol。DeepSeek公布的评测显示,新版DeepSWE v1.1成绩由74.2%提升至77.0%,同表GPT-5.6 Sol和Claude Opus 5分别为73.0%和74.0%;Terminal-Bench 4.0由31.2%提升至42.3%,GPT-5.6 Sol为39.9%;Automation-Bench由54.8%提升至60.5%,GPT-5.6 Sol为45.8%。其中,终端任务成绩提升11.1个百分点,改善幅度较大。模型在代码工程、终端执行和自动化任务上的进步,有利于以较低成本覆盖更多开发者日常工作,为国产高性价比模型进入实际工作流提供支撑。
API价格保持低位,低成本调用支撑Agent任务扩张。截至10月18日,DeepSeek官方价格显示,新版非高峰时段每百万未命中缓存输入、输出Token分别为0.15美元和0.60美元,高峰时段分别为0.30美元和1.20美元;缓存命中输入价格分别为0.003美元和0.006美元。GPT-5.6 Sol在标准短上下文下的当前优惠价格为每百万输入4美元、输出20美元,以DeepSeek峰时未命中缓存价格比较,输入、输出单价分别低92.5%和94%。长周期Agent需要反复读取代码、处理工具结果并开展多轮推理,较低的输入、缓存和输出价格,有利于应用厂商增加任务尝试、部署并行Agent,并将自动化能力拓展至更多高频场景。
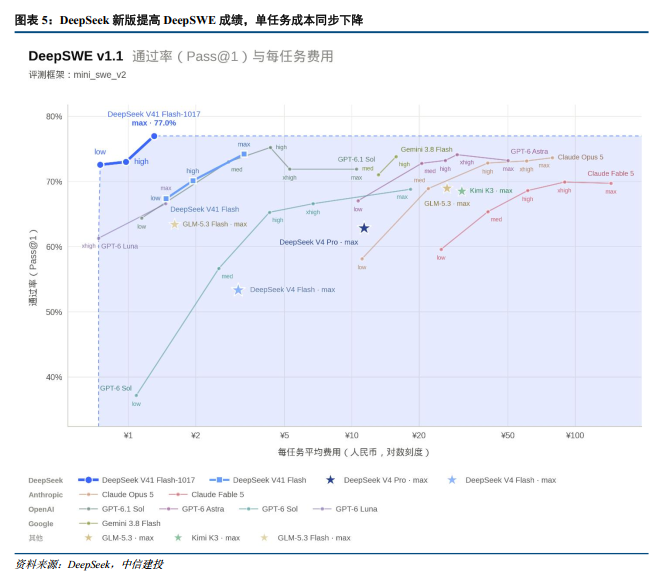
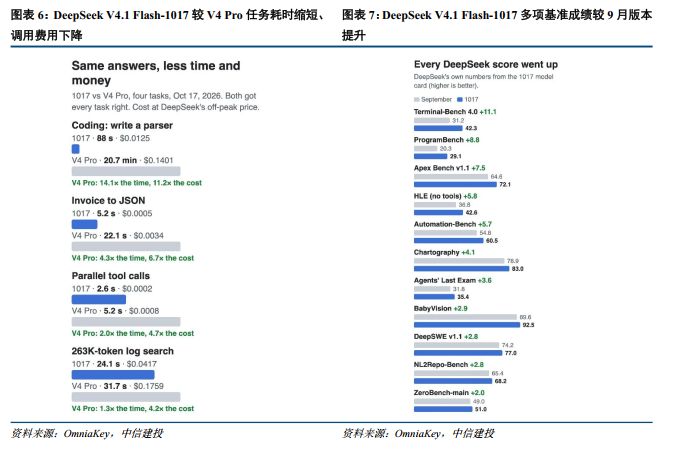
独立实测体现编程性价比,基模效率影响任务完成成本。开发者Ibragim Badertdinov于10月17日更新个人编程评测,选取10个日常工程任务,每种配置重复3次,并通过隐藏测试检查结果。在Pi框架下,DeepSeek V4.1 Flash-1017 high档位30次运行全部通过,平均每任务成本0.045美元;同表GPT-5.6 Sol medium通过率为96.7%,平均成本0.2017美元,新版费用低约77.7%。GPT-6 Luna xhigh同样全部通过,平均每任务Token消耗为29万,低于DeepSeek的54.7万,费用为0.0145美元,体现不同基模与推理配置下的效率差异。OmniaKey于10月18日公布的另一组实测则将新版与V4 Pro对比,两款模型在四项共同任务中均取得正确结果,新版耗时和费用均有所降低。其中,发票转JSON任务均正确提取10项字段,新版耗时5.2秒、费用0.0005美元,V4 Pro分别为22.1秒和0.0034美元;约26万Token日志检索任务耗时由31.7秒缩短至24.1秒,费用由0.1759美元降至0.0417美元。两组实测显示Flash版本已具备较好的日常任务经济性,后续旗舰模型迭代有望进一步提升复杂任务能力和推理效率。
DeepSeek开放搜索与抓取能力,模型和工具协同降低Agent接入成本。10月17日,DeepSeek开放自研Search和Fetch接口,将网页搜索与内容抓取能力提供给开发者。模型能够据此获取外部信息、读取网页内容,并结合代码执行和文件处理完成连续任务,应用范围由离线问答拓展至联网研究、数据分析和工程开发。两个接口均按每千次成功请求0.75美元计费,通过DeepSeek Harness、Claude Code和Codex使用DeepSeek API时,相关服务端调用暂不收费,北京时间11月1日起开始计费。公司同步优化主流编程和办公Agent框架,并开放MIT许可模型权重,有利于开发者沿用既有工具接入,也为企业自建部署和场景定制提供基础。
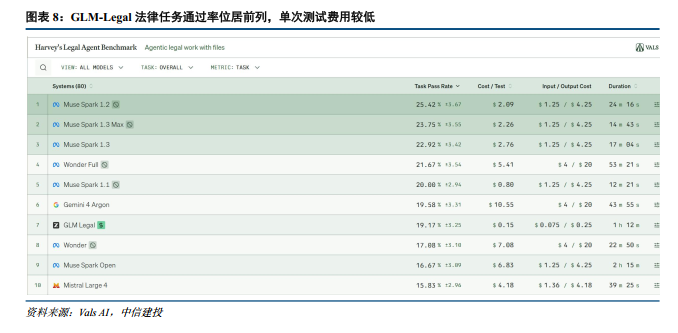
智谱发布法律专用模型,专业训练提升复杂业务交付能力。10月12日,智谱发布基于GLM-5.3-Flash的GLM-Legal,面向合同审查、证据分析和合规研究等法律工作。模型通过法律语料中期训练及数万个真实法律任务环境中的强化学习,学习材料检索、法律分析和文书交付,并同步优化负责上下文管理、工具调用和执行反馈的Agent框架。据公司披露,GLM-Legal在Harvey法律Agent评测中的全项通过率达到19.2%,较基础模型提高12.5个百分点。独立评测机构Vals公布的成绩为19.17%,单次测试费用为0.15美元,在10月12日评测更新时位列第七、前十名中费用最低。专业知识、任务环境和执行框架的联合优化,有望推动高效率国产模型进入法律等专业服务流程。
阶跃披露长程Agent训练方案,模型架构与任务环境协同优化。10月15日,阶跃星辰披露Step 5 Preview的架构与训练细节。模型采用6000亿总参数、270亿激活参数的混合专家架构,支持最高100万Token上下文,面向代码工程、专业知识工作及多轮工具调用任务。公司围绕长程任务构建百万级可验证训练环境,覆盖科学推理、软件工程、机器学习研发及专业工作,并将任务持续时间、跨文件修改深度和结果可验证性纳入训练设计。模型还通过端到端训练的上下文压缩机制,将阶段性工作整理为可恢复状态,支持任务跨越单个上下文窗口继续执行。相关进展显示,国产模型的训练投入向真实任务环境和完整执行流程延伸,有望提升复杂工程任务的完成能力。
风险提示:
应收账款坏账风险;行业竞争加剧;国际环境变化影响。


 扫码下载智通APP